
データインテリジェンスの構成要素と進め方|製造データを「探せる・信じられる」状態にする5ステップ
データインテリジェンスとは、社内に散らばるデータを「探せて、意味がわかり、信頼して使える」状態に保つ取り組みです。データカタログ、メタデータ管理、データリネージ、データ品質、データガバナンスなどを連携させて運用します。データレイクやDWH(データウェアハウス)が「集めて整え、提供する層」だとすれば、データインテリジェンスは「そのデータの意味や信頼性、利用条件を説明できる層」にあたります。人が分析する場合も、AIに参照させる場合も、答えの確かさを支える重要な基盤になります。
この記事では、5つの構成要素、BI(ビジネスインテリジェンス)との違い、導入の5ステップ、実装で詰まりやすい3つの壁を整理します。
データレイクについては、次の記事をご参照ください。
目次
データインテリジェンスを構成する5つの要素と、BIとの役割の違い
データインテリジェンスを支えるのは、メタデータを軸に、データの所在・定義・来歴・品質・利用可否をひとつなぎで扱う仕組みづくりです。特定の製品を導入すれば整うものではなく、運用の設計まで含めた取り組みを指します。
ここでは構成要素と、BIやデータ基盤との役割の違いを押さえます。
データインテリジェンスを支える5つの要素
データインテリジェンスは、次の5つを連携させることで機能しやすくなります。どれかひとつを導入して終わり、という性質のものではありません。
- データカタログ:どこに何のデータがあるかを一覧化し、検索できるようにします。図書館の蔵書目録に近い役割です。
- メタデータ管理:所有者、更新頻度、項目の定義、利用条件といった「データについてのデータ」を管理します。各要素の土台になります。
- データリネージ:あるテーブルや指標が、どのソースからどんな加工を経て生まれたかを追跡します。数字が食い違ったときの原因調査に役立ちます。
- データ品質:欠損、重複、単位の不統一、更新遅延を検知し、状態を可視化します。
- データガバナンス:定義と責任の所在を決め、守られている状態を維持します。ルールを定め、運用を設計する仕組みです。
5つは、同じ重みで独立しているわけではありません。メタデータ管理を共通の土台として、カタログやリネージ、品質、ガバナンスが連携します。所有者と定義が空欄のままでは、検索できても使ってよいかの判断がつきません。
BI・データ分析基盤との違い
BIツールは、集計・可視化した数字をダッシュボードやレポートで見せることを担います。データレイクやDWHは、データを集め、蓄積・整備する層です。データインテリジェンスは、それらを横断して、「その数字はどこから来て、信頼して使えるのか」に答えます。
たとえば、歩留まりのダッシュボードが2つあり、値が0.8ポイント違うとします。BIは違いを表示できますが、理由までは分からないことがあります。リネージとメタデータが整っていれば、片方が検査工程の再検査分を除外していた、といった原因を追跡しやすくなります。
データ分析の高度化を先に進めても、この層が空白だと、同じ確認作業が繰り返し発生しがちです。分析基盤の投資対効果を左右する重要な要素が、この説明可能性です。
データ基盤/データインテリジェンス/BIの役割比較表
| レイヤー | 主な役割 | 答えられる問い | 主な利用者 | 代表的な機能 |
|---|---|---|---|---|
| データインテリジェンス | データの意味・来歴・品質・利用条件を説明できる状態に保つ。 | このデータは何を指し、どこから来て、信頼して使えるか。 | データエンジニア、データサイエンティスト、情報システム担当、業務部門 | データカタログ、メタデータ管理、データリネージ、品質モニタリング、ポリシー管理 |
| BI・分析ツール | 集計結果を可視化し、業務判断に使えるかたちで見せる。 | 何が、いつ、どれだけ起きたか。 | 業務部門、管理職、経営層 | ダッシュボード、レポート、ドリルダウン、アラート |
| データ基盤(DWH・データレイク) | データを集めて保管し、蓄積・整備する。 | データをどこに保管し、どう連携・加工するか | データエンジニア、基盤運用担当 | データ連携・ETL/ELT、ストレージ管理、パイプライン実行、リソース制御 |
なぜいま製造業でデータインテリジェンスが必要とされるのか
主な理由は次の3つです。収集の仕組みが整うにつれ、「集めたものを説明できるか」という次の課題に直面する企業が増えています。
- データは取得できていても成果に結びついていない
- 設計から保守までシステムが分断されている
- 生成AIの回答品質は、参照データの整備状況に大きく左右される
「取れているのに使えない」というギャップ
政府がまとめたものづくり白書の関連調査では、製造業プロセスでデータを取得している企業は66.0%にのぼります。一方、活用できていると答えた企業は51.4%、効果を得られたと答えた企業は43.9%にとどまりました。取得と効果のあいだに、20ポイント以上の差があります。
データ活用の課題として最も多く挙がったのは「知識やノウハウの取得」で57.2%、次いで「導入に必要な人材の確保」が47.9%でした。上位2つはいずれも、人材や組織の知見に関する課題です。
同じ調査では、データ連携にAIを活用していない企業が71.8%を占めました。AIを含むデータ連携の活用が、まだ十分に進んでいない状況もうかがえます。
参考:経済産業省「2026年版ものづくり白書(ものづくり基盤技術振興基本法第8条に基づく年次報告)」
設計・製造・品質・保守でデータが分断される
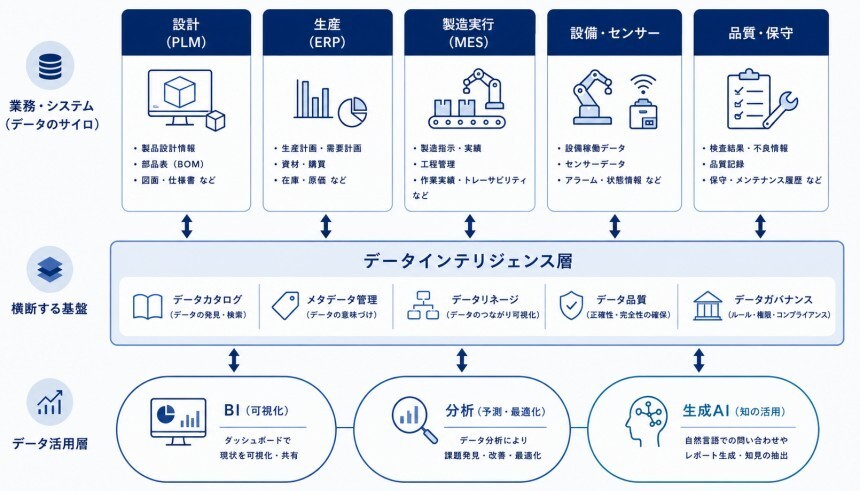
製造業のデータが使いにくい理由には、構造的な事情があります。PLM(製品ライフサイクル管理)は製品仕様を、ERP(基幹業務システム)は計画や原価を、MES(製造実行システム)は現場の実績を主に管理します。それぞれ管理する対象も時間軸も異なります。
さらに、装置メーカーごとにログの形式が異なり、工程ごとにローカルのExcelが挟まることもあります。結果として、ひとつのロットの履歴を追うだけでも、複数部署への問い合わせが必要になることがあります。
たとえば、同じ「良品率」でも、設計部門は試作を含め、製造部門は量産のみを数え、品質保証部門は市場不良を加えることがあります。用語が同じで定義が違う状態は、システム統合だけでは解消しません。定義と責任者を記録・共有する仕組みが必要です。
生成AIの回答精度は、渡すデータの状態で決まる
生成AIの社内活用が進み、データ整備の巧拙が回答品質に表れやすくなりました。定義が揺れたデータをそのまま参照させると、もっともらしい誤答につながるおそれがあります。
いわゆるAI-Readyなデータは、量が多いだけのデータではありません。出所・定義・更新責任が明示され、AIが処理・参照しやすい形になっているデータです。メタデータの整備は、その重要な前提条件のひとつです。
政府の産業政策でも、データの精製やAI-Ready化はAIの活用に不可欠な基盤として位置づけられています。データインテリジェンスは、AI活用の下準備にとどまらず、AIに渡すデータの品質と信頼性を維持・確認するための取り組みです。
製造業のデータ分断と、データインテリジェンスの位置づけ
データインテリジェンスの4つのメリット
データインテリジェンスの主な効果は、「データを探す時間の削減」、「指標の解釈の統一」、「トレーサビリティの向上」、「生成AIの出力精度の向上」です。いずれも「分析が速くなる」より手前の、前提確認にかかっていた時間を減らす効果です。
ここでは各メリットに、対応する測定指標を添えて示します。
1. データを探し、利用条件を確認する時間が減る
データエンジニアや分析担当者の工数は、加工や設計に入る前の「どのデータを使うべきかの確認」に費やされがちです。所在、所有者、利用条件やアクセス方法が可視化されれば、こうした問い合わせを減らせます。
効果はセルフサービス化にもつながります。専門部署への都度の問い合わせを減らし、現場の担当者が必要なデータに安全にたどり着ける状態が理想です。
2. 指標の定義が揃い、認識合わせの手間が減る
指標の算出根拠と更新責任者が明示されると、会議の冒頭で前提を確認する時間が短くなります。数字の解釈がぶれにくくなり、判断そのものに時間を使えます。
担当者が代わったときの影響も小さくなります。属人化していた項目の意味や算出の根拠が記録として残るため、引き継ぎの負担が軽くなります。
3. 品質問題の原因追跡が速くなる
不具合対応では、対象ロットや関係する設計変更を突き止める調査に時間がかかります。リネージとロットトレーサビリティが整っていれば、設計変更から製造実績までの履歴をたどりやすくなります。影響範囲の特定にかかる時間を短縮できます。
同じ仕組みは、規制対応や顧客監査にも役立ちます。説明責任を果たすための資料づくりも、都度の手作業から定型的な出力へ移しやすくなります。
4. 生成AIの回答を業務判断に使えるようになる
社内データを参照する生成AIの回答品質は、参照データの整備状況に大きく左右されます。定義と鮮度をメタデータとして管理し、検索・参照に反映できれば、不適切な表を参照する可能性を下げられます。
同じモデルを使っても、渡すデータの状態次第で結果は変わります。生成AIの活用で成果が出ないときは、データ側も点検してみてください。
データインテリジェンスのメリットと測定指標の例
| メリット | 変化する業務 | 測定指標 | 測定タイミング |
|---|---|---|---|
| 探索時間の削減 |
|
|
着手前に1カ月分を記録。以降は月次で継続。 |
| 解釈のばらつきの抑制 |
|
|
着手前に定例会議2〜3回分を記録。四半期ごとに比較。 |
| 追跡の高速化 |
|
|
直近の発生案件を基準値とし、同程度の案件で比較。 |
| AI出力の回答品質向上 |
|
|
利用開始後、一定件数の回答を基準値とし、整備後に再測定。 |
AIを使った分析の進め方については、次の記事をご参照ください。
AIによるデータ分析を使いこなすには?メリットや重要性、活用手法を徹底解説
データインテリジェンスの導入ステップ【5段階の例】
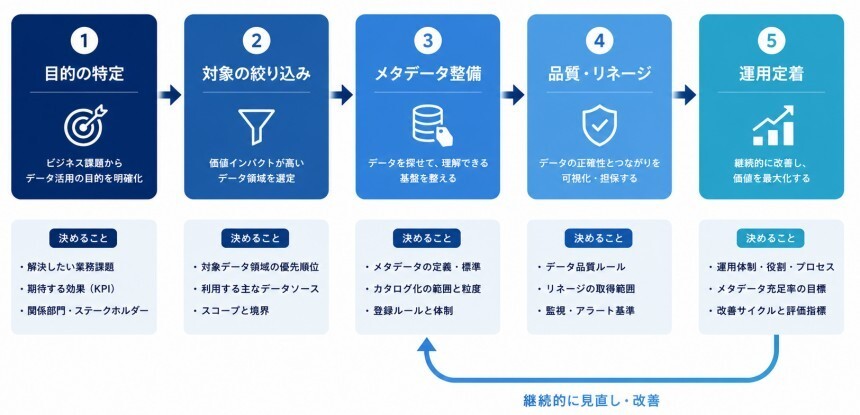
進め方の一例は、①目的とユースケースの特定 ②スコープの絞り込み ③メタデータ収集とカタログ整備 ④品質とリネージの実装 ⑤運用定着、の5段階です。全社のデータを一斉に登録しようとせず、問い合わせが集中している領域から始めるのが現実的です。
ステップ1〜2:目的の特定と対象データの絞り込み
最初に決めるのは「誰のどの困りごとを解くか」です。品質分析の前準備を短くしたいのか、需要予測のインプットを揃えたいのかで、必要なメタデータの項目や粒度が変わります。
ここで陥りやすいのが、ツール導入を目的にしてしまうことです。目的やユースケースを決めずにカタログ製品を先に導入すると、登録対象を選ぶ基準が曖昧になり、全件登録という無理の生じやすい計画になりかねません。
対象データを絞る判断軸の例は次の3つです。この3つが重なる領域から着手すると、効果を示しやすくなります。
- 問い合わせが多いこと
- 複数の部署が同じデータを参照していること
- 定義の食い違いが実際に起きたこと
課題ごとに適した分析手法については、次の記事をご参照ください。
データ分析の手法を徹底解説。課題別アプローチと具体的な活用事例
ステップ3:メタデータの収集とカタログ整備
対象が決まったら、メタデータを集めます。技術メタデータ(テーブル構造、更新日時、データ型)は、自動収集できる場合が多いです。手間がかかるのは、項目の意味や所有者といったビジネスメタデータです。
ここでは利用頻度の高い項目から埋め、残りは整備状況が分かる形で段階的に公開します。空欄を可視化することで、補うべき項目と担当を整理しやすくなります。
ステップ4:データ品質とリネージの整備・可視化
品質チェックは、欠損率、重複、更新遅延、値域の逸脱といった単純な項目から始めます。最初から統計的な異常検知まで導入する必要はありません。
リネージは、主要な指標について、上流のソースからの経路を優先します。すべての依存関係を描くより、たとえば利用頻度の高い指標10本の来歴を追えるようにするほうが、効果を実感しやすくなります。
ステップ5:運用と定着
つくったあとが本番です。データオーナー(データの管理責任者)を役割として明文化し、定義の変更時に更新される流れをつくります。個人の努力に頼らず、業務手順に組み込みます。
定着の指標も決めておきます。たとえば、カタログの月間検索数、メタデータ充足率、所有者が設定された資産の割合です。「登録したか」ではなく「使われているか」を見ることが、形骸化を防ぐ重要なポイントです。
導入ステップのプロセス
ツールを選ぶときに重要な5つの観点
選定の要点は、既存基盤との接続性、メタデータの自動収集範囲、リネージの粒度、アクセス制御・ポリシー連携、運用コストです。機能の豊富さだけでなく、自社の主要データソースに対応しているかを優先的に確認します。
製造業では特に、基幹系だけでなく設備系のデータソースにも対応できるかが重要です。設備データの活用が目的なら、SCADA(設備の監視制御システム)や設備ログを対象外にしたままでは、現場の課題を解決しにくくなります。
自動収集の範囲も確認します。手入力に頼る設計は、運用の負担が積み重なるにつれて更新が滞りがちです。カタログを維持するには、メタデータを自動で取得・更新できる仕組みが重要です。
データインテリジェンス製品の比較チェックリスト
| 確認観点 | 具体的な確認項目 |
|---|---|
| 対応データソース | DWH・データレイク、ERP、MES、設備ログ、SaaS のうち、標準コネクタが用意されているのはどれか。未対応のソースは個別開発になるか。 |
| メタデータの自動収集 | テーブル構造や更新日時をどこまで自動で取得できるか。人が入力する必要がある項目はどれか。定義変更時に自動で反映されるか。 |
| リネージの粒度 | 追跡できるのはテーブル単位か、カラム単位か。ETL処理の中身まで追えるか。BIのダッシュボードまで到達するか。 |
| 権限管理の階層 | 部門・役割・データ資産のどの単位で権限を設定できるか。既存の認証基盤と連携できるか。カタログの閲覧・編集と、実データへのアクセスを分けて管理できるか。 |
| 生成AI連携 | AIからカタログの情報を検索・参照できるか。自然言語での検索に対応しているか。利用者の権限に応じて参照範囲を制御できるか。 |
| 導入・運用の工数 | 初期構築に要する期間と人員。運用時に必要な担当者数と作業時間。ライセンス費用の課金単位(ユーザー数、データ量、資産数、処理量など)。 |
データインテリジェンスの導入で詰まりやすい3つの壁
データインテリジェンスの導入でのつまずきは、技術だけでなく運用設計にも原因があります。カタログが更新されなくなる、利用部門がメタデータを入力しない、効果を説明できず次の投資判断につなげにくい。こうした3つが、特に注意したい壁です。
1. カタログをつくったが、更新が止まる
導入直後は登録が進むものですが、問題はその後です。データは増え続けるのに、カタログの中身だけが止まってしまうことがあります。
更新が誰の業務か、明確になっていないことが原因です。データ資産ごとにオーナーを割り当て、定義変更時の更新を作業手順に組み込みます。自動収集で埋まる部分と、人が埋める部分を最初から分けておくことも効果的です。
2. 現場がメタデータを入力しない
入力を依頼しても埋まらないときは、負担と見返りが釣り合っていないことがあります。入力するのは業務を知る担当者で、恩恵を受けるのは別部署の分析担当になることもあるからです。
まずは入力項目を減らしてください。最初に必須にするのは、所有者と項目の意味です。そのうえで、入力した定義が実際に検索や分析で使われている様子を、入力を依頼した部門に見せます。自分が書いたものが誰かの役に立っていると伝われば、次の依頼にも協力を得やすくなります。
もうひとつ有効なのが、既存文書から定義を取り込み、確認・補完することです。ゼロから書かせるのではなく、既存の記述を確認して活用します。
3. 効果を説明できず、次の投資につながらない
3つ目は成果の説明です。前掲の調査でも、AI・デジタル活用の課題として知識やノウハウ、人材の確保が上位に挙がっていました。効果を示せなければ、体制や予算を広げる判断につなげにくくなります。
着手前の状態を測っていないと、効果を説明しにくくなります。導入後に「探しやすくなりました」と報告しても、比べる数字がなければ効果を説明しにくくなります。
対策は、着手前に基準値を取ることです。データ所在に関する問い合わせ件数、分析着手までのリードタイム、指標定義の差し戻し回数、不具合の影響範囲特定にかかった時間。この4つを記録しておくと、導入後の効果を説明しやすくなります。
そのうえで、少なくとも3つの視点で評価します。「分析担当者の工数」、「業務部門の意思決定の速さ」、「ガバナンス面のリスク低減」です。効率化だけでなく、統制面の効果も示すことが重要です。
データ基盤の設計から運用定着まで、段階ごとに必要な知見を補える支援先を選ぶことが重要です。自社の課題を整理する段階から相談できるかも、選定時の確認ポイントになります。
自社で進めるか、外部の支援を受けるかの判断軸については、次の記事をご参照ください。
データ分析のはじめ方:自社推進とコンサル活用、成功への最適な選択は
まとめ:データインテリジェンスが成果を左右する
製造プロセスでのデータ取得は進みました。それでも、効果を得られている企業は43.9%にとどまります。この差の一因は、集めたデータをどれだけ説明できるかにあります。
データインテリジェンスは、カタログ、メタデータ、リネージ、品質、ガバナンスを連携させて、データが何を指し、どこから来て、信頼して使えるかを示します。この層の整備は、分析基盤の投資を生かし、生成AIの回答を業務で使いやすくする重要な条件です。
とはいえ、全社のデータを一度に整える必要はありません。問い合わせが集中している領域をひとつ選び、着手前の数字を記録してから始めれば、次に何をすべきかを判断する材料が得られます。範囲を絞って測りながら広げるほうが、着実に進めやすくなります。
NTTデータ関西では、蓄積されたデータを活用し、データ分析・活用基盤の構想策定、構築・運用から全社定着まで支援する「データ分析・活用ソリューション」を提供しています。データ活用の具体的な取り組みについては、担当者インタビュー記事もあわせてご参照ください。
構想から定着までデータ活用の道のり -お客様と共に歩むNTTデータ関西
データインテリジェンスに関するよくある質問
Q1. データインテリジェンスとは何ですか。
組織内のデータを発見し、意味を理解し、信頼性と統制を確保しながら活用できる状態をつくる取り組みです。データカタログ、メタデータ管理、データリネージ、データ品質、データガバナンスなどを連携させて運用します。
Q2. BIツールとの違いは何ですか。
BIは、集計結果を可視化し、「何が起きたか」を把握するために使います。データインテリジェンスは、「その数字がどこから来て、信頼して使えるか」を確認しやすくする層です。役割は一部重なりますが、データインテリジェンスはBIの信頼性を支える位置づけです。
Q3. データ基盤(DWH・データレイク)があれば、データインテリジェンスは不要ですか。
多くの場合、不要にはなりません。基盤は主にデータを集めて保管・整備する層で、意味づけや利用条件の管理は別途必要になることがあります。基盤にデータが集まるほど、探索と解釈のコストが増えやすくなるため、カタログやメタデータの整備が重要になります。
Q4. データマネジメントやデータガバナンスとは、どのような関係がありますか。
データマネジメントは、データを資産として管理・活用する営み全体を指し、データガバナンスはそのなかの統制部分です。データインテリジェンスは、メタデータを軸に両者をつなぎ、データを実際に使える状態へ導く取り組みです。
Q5. 製造業で最初に着手すべき領域はどこですか。
まずは、問い合わせが多く、複数の部署が参照し、定義の食い違いが実際に起きている領域です。品質データや設備稼働データは、この3条件が重なる場合があり、初期の効果を示しやすい領域です。
Q6. 生成AIの活用と、どのように関係しますか。
社内データを参照する生成AIの回答品質は、参照データの整備状況に左右されます。定義や更新責任が明示されたデータを参照できるかは、誤答のリスクを左右する要素のひとつです。データインテリジェンスは、そのデータ面の前提を整える取り組みです。
 業種から探す
 ランキング